
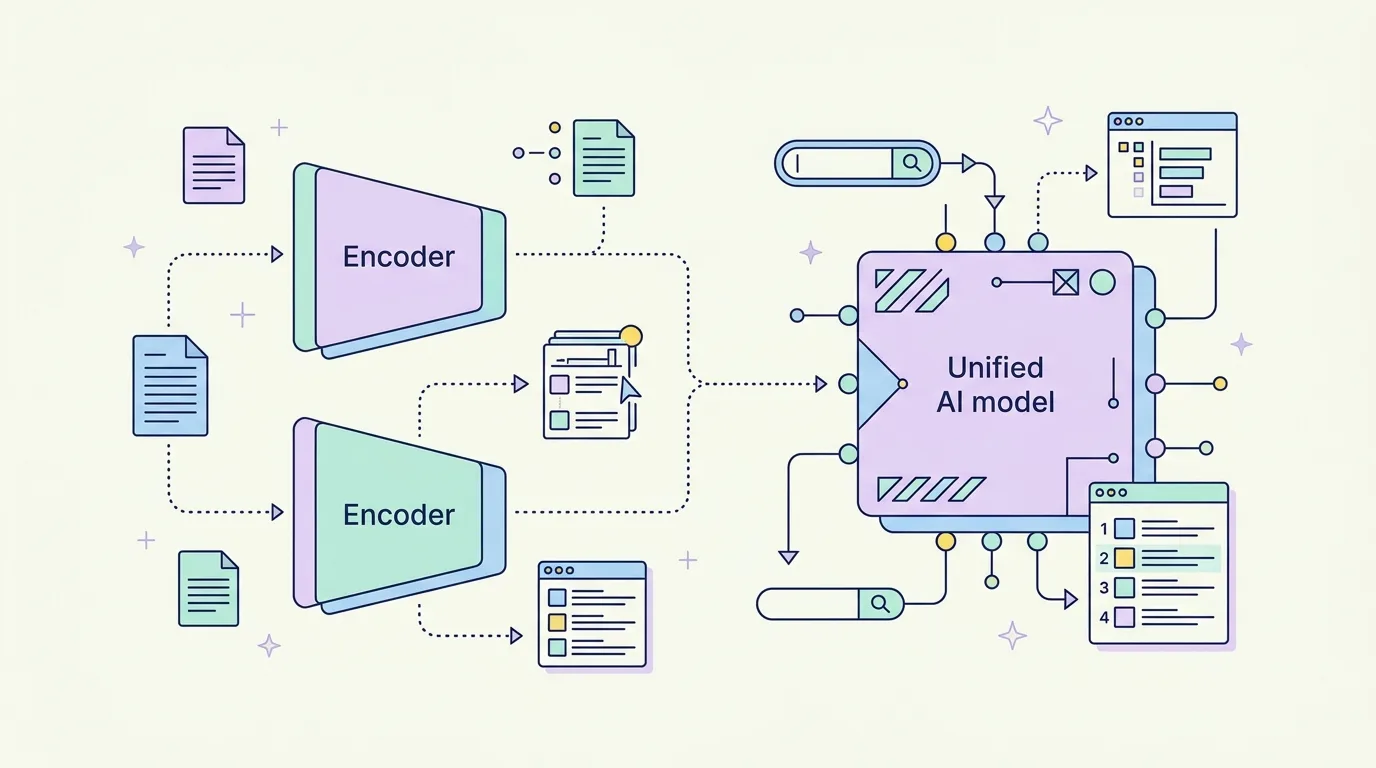
Исследователи Google DeepMind совместно с учёными из Университета Массачусетса и Техасского университета опубликовали работу, в которой предлагают радикально изменить архитектуру поискового ранжирования. Вместо привычной двухэтапной системы они описывают подход под названием Autoregressive Ranking (ARR) — единую языковую модель, которая самостоятельно формирует ранжированный список документов.
Статья называется Autoregressive Ranking: Bridging the Gap Between Dual and Cross Encoders. Если подобный подход будет внедрён в реальные поисковые системы, последствия для SEO и AEO окажутся весьма значительными.
Как устроено текущее ранжирование в поиске
Современные поисковые системы, включая Google, используют двухэтапную архитектуру. На первом этапе работает Dual Encoder (DE) — он преобразует запросы и документы в векторы и быстро отбирает кандидатов. Это вычислительно дёшево и быстро, но точность ограничена.
На втором этапе подключается Cross Encoder (CE) — более мощная модель, которая детально анализирует и ранжирует отобранные кандидаты. Cross Encoder точнее, однако слишком ресурсоёмок для работы с полным корпусом документов, поэтому применяется только на финальной стадии.
Ключевое ограничение Dual Encoder состоит в том, что при росте числа документов размер вектора вынужден расти пропорционально — иначе система не может представить все возможные порядки ранжирования. ARR этого ограничения лишён: теоретически он способен ранжировать произвольное число документов при фиксированном размере скрытого состояния.
Метод обучения SToICaL и результаты тестирования
Для обучения ARR исследователи разработали метод SToICaL (Simple Token-Item Calibrated Loss). Он решает две задачи одновременно: присваивает больший вес документам, которые должны ранжироваться выше, и увеличивает вероятность токенов, ведущих к более релевантным документам. В результате модель учится не только выдвигать нужные документы вперёд, но и подавлять нерелевантные.
Тестирование проводилось на двух наборах данных — WordNet и ESCI Shopping Queries. В экспериментах на WordNet ARR показал результаты, сопоставимые с Cross Encoder, и существенно превзошёл Dual Encoder. Метод SToICaL значительно улучшил ключевые метрики ранжирования и снизил количество ошибок, когда нерелевантный документ попадает выше релевантного.
Вместе с тем в тесте на поисковых запросах из сферы e-commerce одна из версий метода ухудшила точность на первой позиции, хотя общее качество ранжирования улучшилось. Авторы признают, что этот аспект требует дополнительного изучения.
Что это означает для SEO-специалистов
Исследование подтверждает: сегодня Dual Encoder и Cross Encoder по-прежнему занимают центральное место в поисковом ранжировании. Разговоры о том, что «всё уже изменилось» из-за ИИ, преждевременны — по крайней мере, в части базовой архитектуры поиска.
Однако работа Google DeepMind показывает, что компания целенаправленно движется к фундаментальной замене этой архитектуры. Если ARR когда-либо будет внедрён в production, логика отбора и ранжирования документов изменится на уровне, недоступном для наблюдения извне. SEO-специалистам стоит следить за развитием этого направления: смена парадигмы ранжирования означает пересмотр базовых представлений о том, какие сигналы влияют на позиции в выдаче.
Источник:
Search Engine Journal — https://www.searchenginejournal.com/google-deepmind-develops-new-ai-search-ranking-model/
