
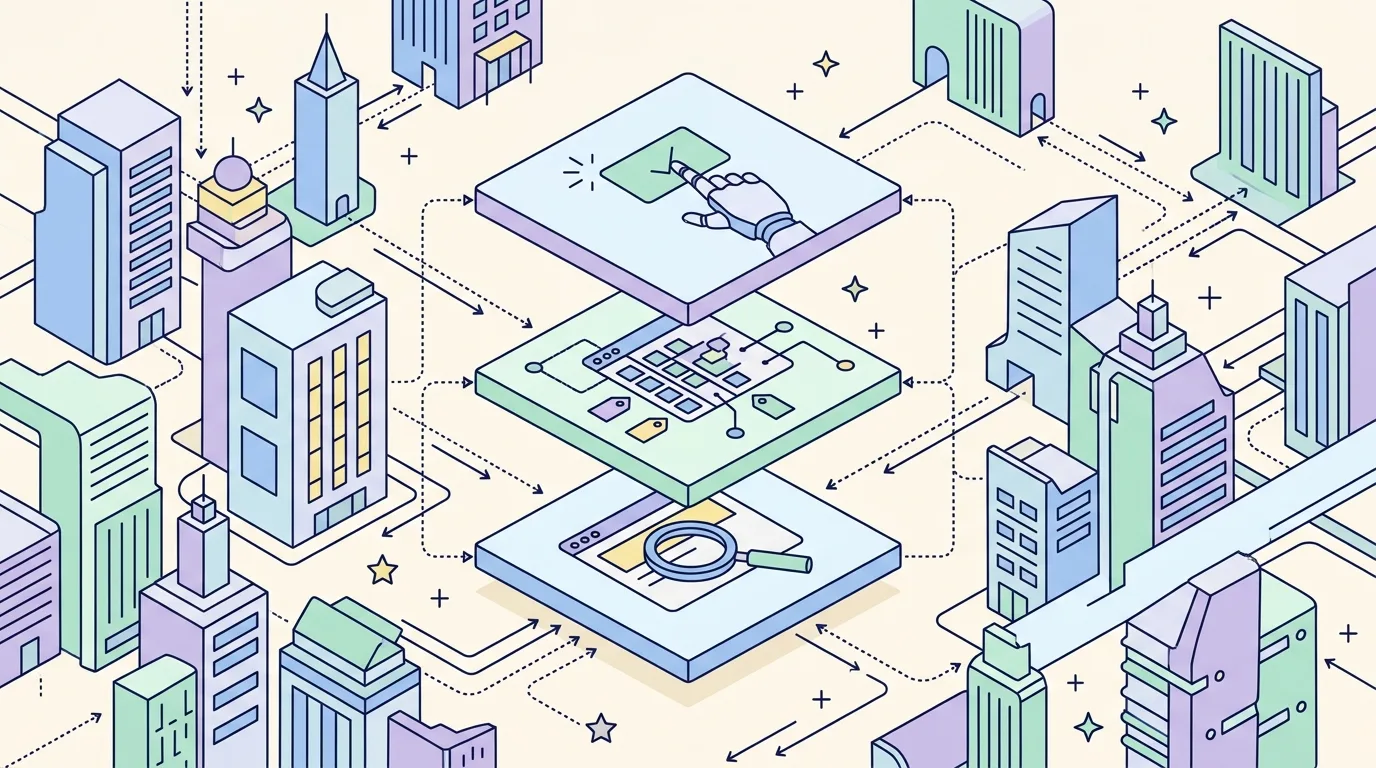
Исследование агентства SALT.agency охватило 50 крупных сайтов из сфер ритейла, SaaS, туризма, медиа и финансов. Его результаты показали: большинство ресурсов сделали контент доступным для AI-ботов, но почти никто не обеспечил условия для его полноценного понимания. При этом почти две трети сайтов не приняли никакого осознанного решения о том, каким AI-системам разрешён доступ к их контенту.
Авторы исследования предлагают трёхуровневую модель AI-готовности, которая выходит за рамки привычного подхода «получить упоминание в AI-ответе». Данные собирались 12 июня 2026 года с помощью инструментированного браузера, фиксирующего HTTP-ответы, рендеринг DOM и серверный HTML.
Три уровня AI-видимости: от доступа к действию
Первый уровень — извлекаемость — отвечает на вопрос, может ли AI вообще получить и разобрать контент сайта. Он пересекается с классическим техническим SEO: robots.txt с директивами для AI-ботов, семантический HTML, ARIA-разметка, серверный рендеринг, карта сайта. Средний балл по этому уровню составил 74,4% — относительно высокий результат, поскольку многие элементы уже были внедрены для нужд традиционного поиска.
Второй уровень — атрибуция и смысл — определяет, способна ли AI-система понять, что именно находится на странице и кому принадлежит. JSON-LD разметка позволяет AI отличить цену товара от скидки, определить бренд и оценить экспертность автора. Средний балл здесь — всего 38,5%. JSON-LD присутствовал на главных страницах лишь 35 из 50 сайтов, а Content Signals Policy от Cloudflare — инструмент, позволяющий гибко управлять правами AI-краулеров на индексацию, ответы и обучение моделей, — внедрили только 5 сайтов из 50.
Третий уровень — агентные транзакции и обнаружение — касается способности AI-агентов выполнять действия на сайте от имени пользователя: совершать покупки, бронировать услуги, обращаться к API. Средний балл — 2,1%. Из 48 сайтов, доступных для тестирования, 46 набрали ноль. Только Airbnb и Vercel реализовали OAuth-метаданные авторизационного сервера, но не защищённого ресурса. Протоколы аgentic commerce — Google UCP и OpenAI ACP — пока остаются в статусе развивающихся стандартов.
Сигналы без гарантий: robots.txt, llms.txt и их реальные ограничения
11 из 50 сайтов опубликовали файл llms.txt — структурированное описание контента и бренда для AI-систем. Однако этот стандарт пока не ратифицирован ни одним регулирующим органом и классифицируется авторами как «пограничный». Показателен пример Expedia: сайт разместил детально проработанный llms.txt, но не имеет JSON-LD разметки, не объявил карту сайта и отдаёт менее четверти контента на стороне сервера. Итоговый балл — 33,3%.
Директивы в robots.txt и Content Signals Policy носят рекомендательный характер: крупные краулеры (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended) их соблюдают, но механизмов принудительного исполнения не существует. Технические сигналы повышают вероятность корректной интерпретации контента, но не гарантируют её.
Осознанный выбор важнее высокого балла
Лидером по итогам аудита стал Airbnb с результатом 79,2%. Amazon набрал лишь 29,2% — намеренно заблокировав большинство AI-ботов директивами в robots.txt. BBC, CNN и The Guardian также закрыты для AI-краулеров: их бизнес-модель строится на прямом трафике читателей. Авторы подчёркивают: низкий балл сам по себе не означает проблему, если он отражает взвешенное решение.
Критичнее другое: 29 из 50 сайтов не приняли вообще никакого решения. Ни блокировок, ни явных разрешений — доступ AI к контенту и его интерпретация фактически отданы на волю случая.
Для SEO- и digital-команд практический вывод очевиден: работа с AI-видимостью не ограничивается получением упоминаний. Структурированная разметка, чёткие директивы для AI-ботов и подготовка к агентным взаимодействиям — это три самостоятельных направления, каждое из которых требует отдельного аудита и стратегии.
Источник:
Search Engine Journal — https://www.searchenginejournal.com/the-technical-signals-ai-search-uses-that-most-seos-still-arent-optimizing/
