
Исследователи Google DeepMind совместно с учёными из Массачусетского университета и Университета Техаса опубликовали научную работу, в которой предлагают заменить стандартную двухэтапную архитектуру поисковых систем единой языковой моделью. Разработка называется Autoregressive Ranking (ARR) и теоретически способна устранить ключевые ограничения существующих подходов к ранжированию.
Если такая система когда-либо появится в основном алгоритме Google, это может кардинально изменить логику поискового ранжирования — а значит, и подходы к SEO.
Как устроены нынешние системы ранжирования
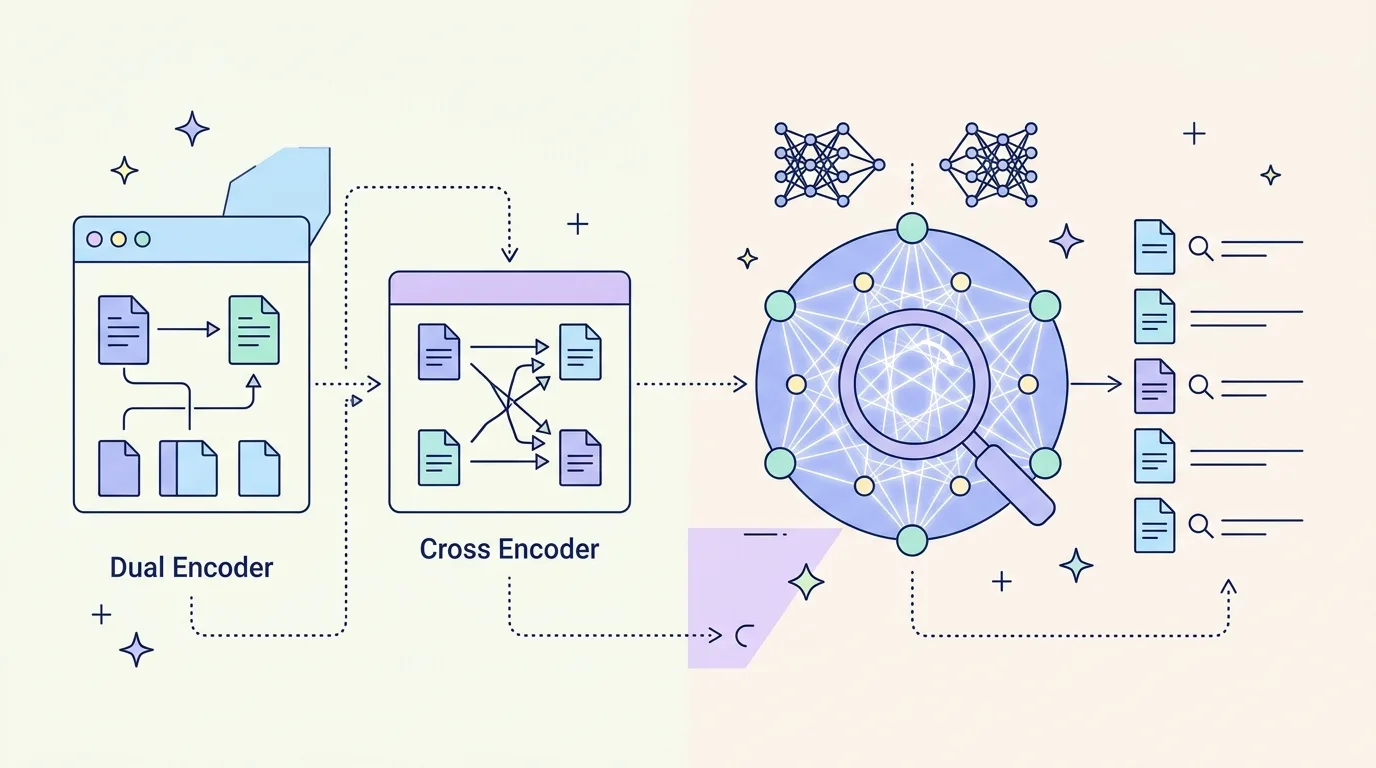
Современные поисковые бэкенды, как правило, работают в два этапа. Первый — Dual Encoder (DE): он преобразует запросы и документы в векторы и быстро отбирает кандидатов среди огромного массива страниц. Этот этап вычислительно дёшев и быстр, но ограничен по точности.
Второй этап — Cross Encoder (CE): он более мощный и точно оценивает релевантность отобранных документов, однако требует значительных вычислительных ресурсов, поэтому применяется только к уже отфильтрованному набору кандидатов.
Ключевое ограничение Dual Encoder состоит в том, что по мере роста числа документов для ранжирования размер вектора должен пропорционально увеличиваться. ARR, согласно теоретическому анализу исследователей, лишён этого ограничения: модель с постоянным скрытым измерением способна ранжировать произвольное количество документов.
Метод обучения SToICaL и результаты тестов
Для обучения языковой модели правильно ранжировать документы исследователи разработали метод SToICaL (Simple Token-Item Calibrated Loss). Он учит модель двум вещам: присваивать больший вес документам, которые должны стоять выше, и направлять вероятность токенов в сторону более релевантных результатов.
Тестирование проводилось на двух наборах данных — WordNet и ESCI Shopping Queries. В экспериментах на WordNet ARR показал результаты, сопоставимые с Cross Encoder, и значительно превзошёл Dual Encoder. Кроме того, метод обучения SToICaL существенно снизил количество случаев, когда нерелевантные документы оказывались выше релевантных.
Вместе с тем в тестах на поисковых запросах из сферы e-commerce одна из версий метода ухудшила точность ранжирования самого релевантного результата на первой позиции, хотя общее качество сортировки улучшилось. Исследователи признают, что этот аспект требует доработки.
Что это значит для SEO и поиска
Важно понимать: на данный момент нет никаких подтверждений того, что ARR используется в реальном алгоритме Google. Это академическое исследование, а не анонс нового фактора ранжирования. Связывать его с текущими изменениями позиций сайтов преждевременно.
Тем не менее работа демонстрирует направление, в котором движется поисковое ранжирование. Если LLM-модели заменят двухэтапные системы, оценка страниц будет строиться не на отдельных сигналах, а на целостном понимании того, насколько контент решает задачу пользователя. Для SEO-специалистов это означает смещение акцента в сторону реальной полезности материала и его способности закрывать поисковые интенты, а не оптимизацию под технические метрики.
Источник:
Search Engine Journal — https://www.searchenginejournal.com/google-deepmind-develops-new-ai-search-ranking-model/589062/
